4 часа на восстановление — это не героизм, а система
Четыре часа на восстановление критического инцидента — это не про героизм инженера ночью. Это про систему, которая построена до того, как что-то упало.

Вот сценарий, который я видел много раз.
Заказчик подписывает SLA: «решение критического инцидента — 4 часа». Инцидент случается. Инженер открывает инфраструктуру и понимает, что он её не знает. Документации нет. Схемы нет. Что где стоит — загадка. ЗИПа нет. Доступа к нужному оборудованию нет.
И четыре часа уходят не на решение, а на знакомство.
Для нас четыре часа — не запредельная цифра. Это нормальный рабочий срок, если правильно подготовиться. Но подготовка начинается задолго до первого инцидента — ещё до подписания договора.
Сначала — приёмка на поддержку
Процесс начинается не с SLA, а с приёмки инфраструктуры на поддержку. Прежде чем обещать что-то чинить, нужно понять, что именно вы берёте.
Первый шаг — экспресс-аудит. Знакомство с объектом, оценка общего состояния, карта объекта, проверка базовой информационной безопасности: резервные копии, антивирус, доступы.
Второй шаг — инвентаризация. Оборудование, ПО, конфигурации. Всё, что есть. Не «примерно», а точно. Если вы не знаете, что стоит у заказчика, вы не знаете, что чинить, когда оно упадёт. О том, как такая документация живёт потом, — в статье «Регламентное обслуживание и документация».
Карта рисков и план без иллюзий
По результатам аудита составляется карта рисков:
- где узкие места и что упадёт первым;
- что критично, а что может подождать;
- что уже снято с производства, и запчастей на это не будет;
- где нет резервирования — например, в RAID один диск вместо двух.
И только после этого — план поэтапного устранения узких мест. Не «мы всё починим завтра», а «эти три точки закрываем в первый месяц, эти пять — во второй». Инфраструктуру, которая строилась годами, нельзя починить за неделю. Честный план с заказчиком лучше красивого обещания.
Мониторинг: узнать раньше заказчика
Если заказчик позвонил первым — вы уже опоздали.
Мониторинг ставится либо у заказчика, если у него есть своя команда, которая будет за ним следить, либо на стороне исполнителя. В любом случае он должен ловить деградацию до того, как она станет инцидентом.
Диск заполнен на 95%? Это ещё не инцидент, но уже алерт. Температура в серверной поднялась? Это ещё не отказ, но уже повод позвонить.
И алерт должен прийти туда, где инженер его увидит. Не на почту, которую разбирают раз в день. В мессенджер, в тикет-систему, на телефон.
ЗИП с доступом 24/7
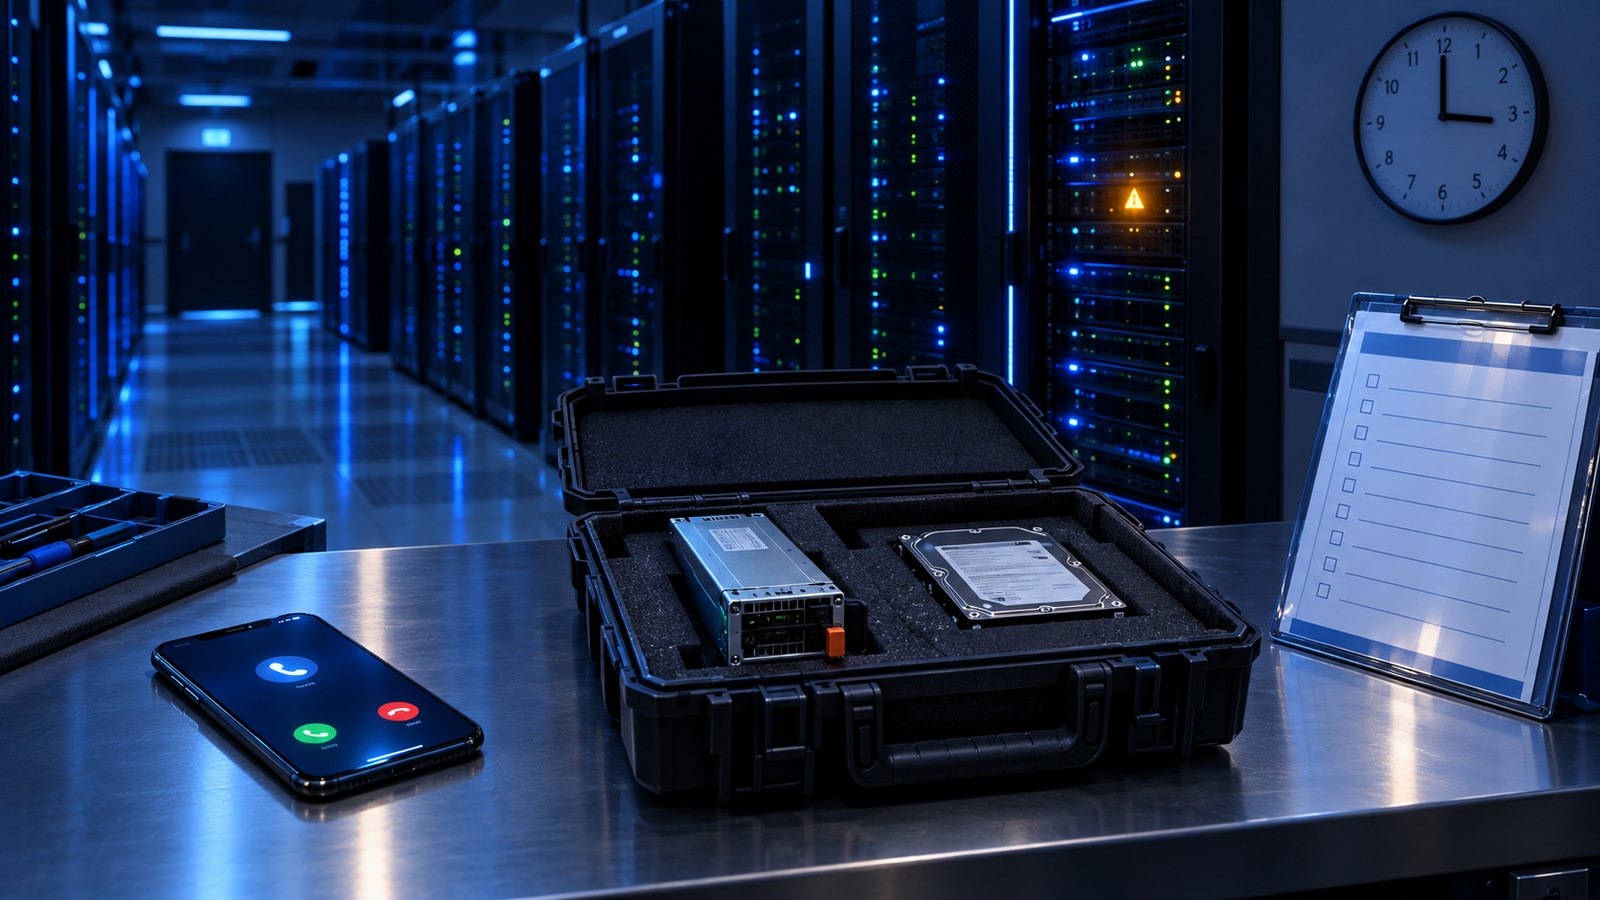
Можно иметь идеальный мониторинг, идеальную эскалацию и идеальных инженеров. Но если в три часа ночи сгорел блок питания, а запасного нет, четыре часа превращаются в «поехали в магазин, он откроется в десять».
Поэтому создаётся оперативный ЗИП — у заказчика или на своей территории: всё, что может потребоваться для горячей замены. Главное — доступ 24/7. Инженер должен приехать в любое время, взять нужную деталь и ехать дальше. Без «подождите до утра, кладовщик придёт».
Состав ЗИП определяет карта рисков. Если в инфраструктуре есть оборудование, снятое с производства, и запчастей на рынке нет, ЗИП для него формируется в первую очередь. Когда оно упадёт, чинить будет нечем.
Эскалация — это звонок, а не бумажка
Здесь многие компании спотыкаются.
Матрица эскалации есть. Красивая: «если инженер не взял инцидент за 15 минут — передать старшему». Но на деле никто не передаёт. Потому что «он же онлайн», «он обычно быстро отвечает», «не хочу дёргать по мелочи». В итоге критический инцидент висит час, потому что все надеются друг на друга.
Правильная эскалация выглядит иначе. Критический инцидент назначен инженеру — инженеру поступает звонок. Не сообщение в мессенджере, которое можно пролистать. Не письмо, которое уйдёт в спам. Звонок. Критический инцидент — это не «посмотрю после обеда». Это «встань и иди».
Если инженер не взял инцидент в работу за N минут — звонок тимлиду, дальше — по цепочке до руководителя подразделения. Это может звучать жёстко. Но если инженер спит, а вы об этом не знаете, в четыре часа вы не уложитесь. Никогда.
Дежурства: ночь и выходные не отменяются
Критические инциденты не случаются по расписанию. Они случаются в субботу вечером, в новогоднюю ночь, в тот момент, когда все ушли.
Поэтому внутри исполнителя распределяются дежурства: ночные, выходные, праздничные. Не «на общественных началах», а по чёткому графику: кто сегодня дежурит, кто его подменяет, как с ним связаться.
Дежурный инженер знает: если приходит критический тикет, он бросает всё и берётся за него. Это его смена. Без этого «четыре часа» работают только в будни с 9 до 18. В остальное время — как получится.
Регламент, который работает, и регламент ради регламента
Андрей Громов недавно писал о том, почему умирают большие компании, и одной из причин назвал бюрократию, которую никто не контролирует. Может показаться, что всё описанное выше — та самая бюрократия: аудит, карты, матрицы, графики.
Разница — в том, кому служит документ.
Бюрократический регламент существует, чтобы было на кого показать пальцем. Его пишут один раз, кладут в папку и вспоминают после аварии. Рабочий регламент существует, чтобы в три часа ночи инженер не думал, а действовал. Каждый элемент системы точно знает, что делать, когда что-то идёт не так.
Простой тест: если регламент ни разу не менялся после реального инцидента, это бумажка.
Цифры это подтверждают. По данным Uptime Institute, 85% крупных сбоев, вызванных человеческим фактором, связаны с тем, что персонал не выполнял процедуры, или с ошибками в самих процедурах (Uptime Institute, 2025). Проблема не в том, что регламентов много или мало. Проблема в том, что они либо не работают, либо не живут.
Международный стандарт менеджмента ИТ-сервисов, принятый в России как ГОСТ Р ИСО/МЭК 20000-1-2021, построен на той же идее: сервис нужно спланировать, внедрить, измерять и постоянно улучшать. Регламент — это не памятник, а инструмент.
Что убивает скорость реакции
Можно написать в SLA хоть «15 минут», а по факту ждать три часа. Вот что обычно мешает.
Человеческий фактор. Инженер увидел алерт, но подумал: «Сейчас доем и займусь». Или не понял, что это критично. Или у него уже три таких же, и он выбирает, какой важнее. Человек — самое ненадёжное звено в любой системе реакции. И самое дорогое.
Разрыв между инженерами и руководителями. Руководитель думает: «У нас SLA 98%, мы молодцы». Инженер думает: «Вчера я три часа чинил то, что можно было починить за час, если бы мне сразу дали доступ». Они смотрят на разные цифры и говорят на разных языках. Пока они не сядут и не поговорят о реальных узких местах, ничего не изменится.
Шум в алертах. Мониторинг настроен так, что за ночь приходит 200 уведомлений, из них 190 некритичных. Инженер перестаёт на них смотреть. И пропускает то самое, двести первое, которое было настоящим.
Отсутствие обратной связи. Инцидент закрыли. Никто не разобрал, почему он занял столько времени. Никто не обновил runbook, никто не поменял алерт. Через месяц всё повторится, и снова будут «героически чинить» вместо того, чтобы не допустить.
Почему это работает
Соберём всё вместе. Мониторинг ловит проблему до того, как её заметит заказчик. Алерт приходит инженеру. Если инцидент критический — звонок. Инженер берёт его в работу в течение минут. Он знает инфраструктуру, потому что аудит и описание сделаны заранее. У него есть runbook, потому что процессы прописаны. У него есть ЗИП, потому что мы предусмотрели, что может сломаться. Если он не справляется, эскалация срабатывает автоматически, а не «когда кто-то вспомнит».
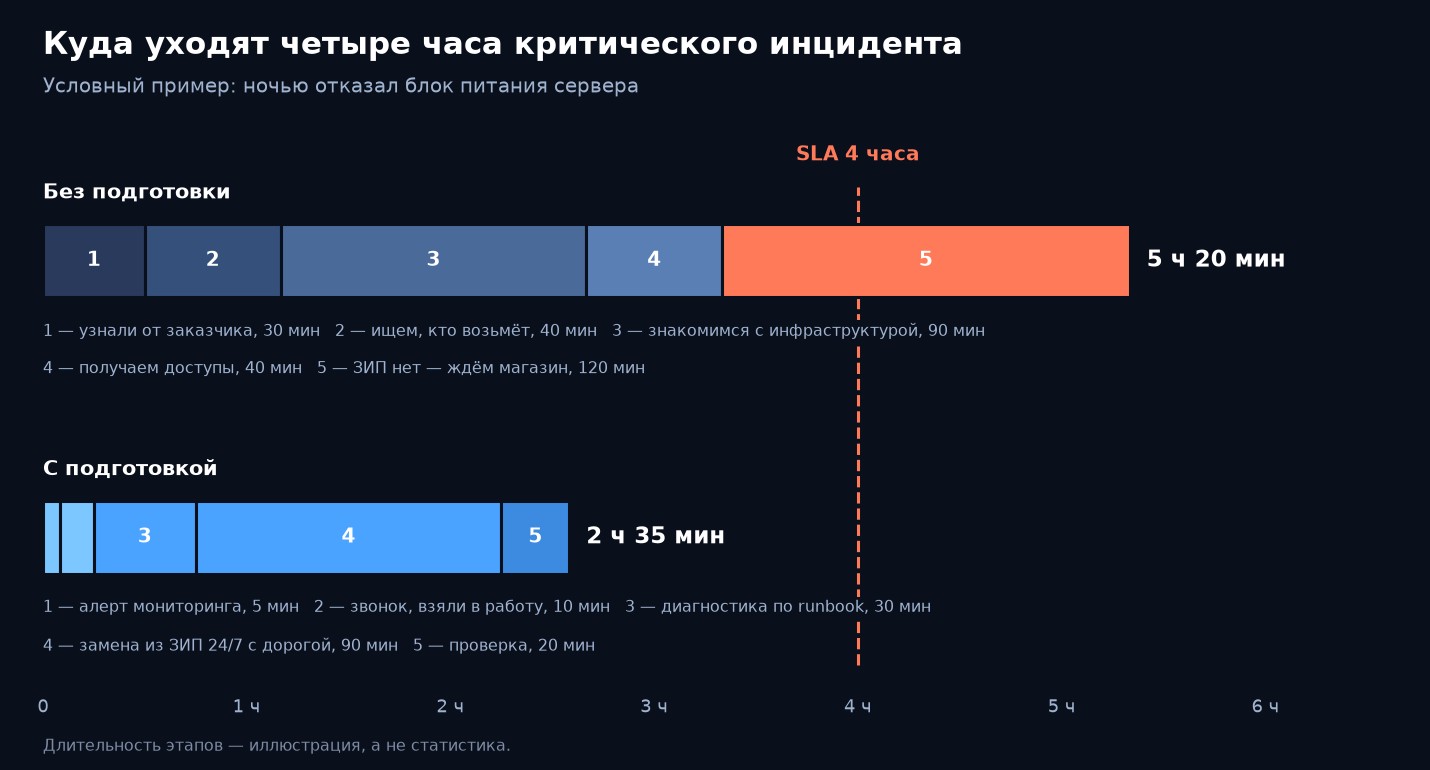
И тогда четыре часа — это не обещание. Это инженерный расчёт.
В нашей практике именно такая комбинация — аудит, карта рисков, мониторинг, ЗИП 24/7, эскалация со звонком и дежурства — позволяет почти всегда восстанавливать работу в срок. Не потому что инженеры — супергерои. А потому что система построена так, чтобы у них не было причин опоздать.
Что в итоге
Четыре часа на восстановление — это не про скорость реакции. Это про то, что происходит до инцидента.
Если за этими четырьмя часами стоят аудит, описание, карта рисков, мониторинг, ЗИП 24/7, эскалация со звонком и дежурства — вы успеете.
Если за ними стоит только строчка в договоре и надежда, что инженер «как-нибудь разберётся», — вы не успеете. Ни за четыре часа, ни за четыре дня.
Александр Фурсов
Директор по интеграции ООО «Атримут»
Многолетний опыт в ИТ, эксперт в аутсорсинге.