Регламентное обслуживание серверов: почему РТО дешевле аварии
Качественный ИТ-сервис начинается не с быстрого устранения аварий, а с регламентного технического обслуживания и актуальной документации. По моей практике, около половины инцидентов возникает именно там, где на них сэкономили.

За годы работы в сервисном бизнесе через мои проекты прошли десятки миллионов инцидентов. И чем больше их было, тем твёрже я убеждался в простом постулате: качественный сервис начинается не с организации оперативного устранения инцидентов, а с регулярного технического обслуживания и поддержания технической документации в актуальном состоянии.
Это звучит скучно. Аварийная бригада, которая ночью подняла упавший сервис, выглядит героически. Инженер, который раз в полгода продувает сервер и обновляет схему коммутации, — не выглядит героем. Но именно второй делает так, чтобы первому не пришлось выезжать.
Откуда берутся инциденты
Статистика проектов, которые через меня прошли, устойчиво показывает две цифры:
- около 40 % инцидентов возникает из-за несвоевременно проведённого или вообще не проведённого регламентного технического обслуживания (РТО);
- ещё около 10 % — из-за неактуальной или отсутствующей технической документации.
То есть примерно каждый второй инцидент был предотвратим ещё до того, как случился.
Мировая статистика говорит о том же. По данным Uptime Institute, человеческий фактор так или иначе участвует в 2/3–4/5 всех инцидентов в дата-центрах. Среди сбоев по вине персонала 58 % вызваны несоблюдением процедур, а 45 % — некорректными процедурами и регламентами (ServerNews). Ещё 16 % связаны с отсутствием регулярного планово-предупредительного обслуживания (Telecombloger). Сами операторы ЦОД это понимают: 80 % считают, что последнего сбоя можно было избежать при лучшем управлении (ICT.Moscow).
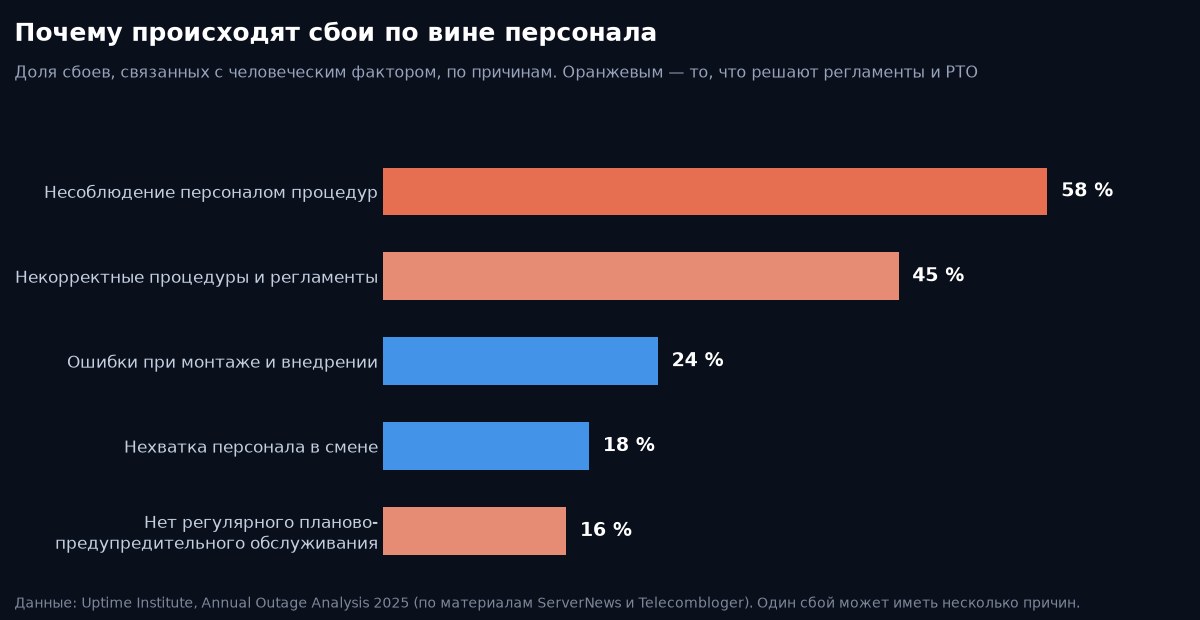
Пыль — самый дешёвый инцидент, который можно предотвратить
Самый наглядный пример — обычная пыль. Она оседает на вентиляторах, радиаторах процессоров и блоках питания и работает как теплоизолятор. По данным, которые приводит Servermall, без регулярной очистки рабочая температура электроники может вырасти на 16,5 °C (Хабр). Перегрев считается главным врагом серверов: уже выше +30 °C растёт риск сбоев, а выше +35 °C вероятность отказов растёт лавинообразно (РБК Компании).
Сравните два сценария.
Первый: раз в полгода инженер выводит сервер в окно обслуживания, очищает его от пыли, проверяет вентиляторы и журналы. Это несколько часов работы по плану.
Второй: сервер годами стоит без обслуживания, перегревается и выходит из строя. Теперь нужно покупать новый сервер, срочно восстанавливать сервисы и данные, а бизнес всё это время простаивает. Средняя стоимость одного критичного простоя в российских компаниях приближается к 2 млн рублей (Киберпротект), и она продолжает расти: в 2025 году стоимость часа простоя выросла у 39 % компаний (CNews).
Разница между этими сценариями — порядки, а не проценты.
Документация: когда инженер работает как сапёр
С документацией история менее очевидна, но последствия бывают тяжелее. Два примера из практики.
Пример 1. SAN
У одного сервера пропала связность с сетью хранения данных (SAN). Инцидент небольшой: затронута вспомогательная инфраструктура. Инженер приезжает на объект без схемы коммутации или со схемой трёхлетней давности. Какой порт фабрики к чему подключён, неизвестно. И он, как сапёр, начинает наугад переключать линки на SAN-коммутаторах.
Итог: вместо одного сервера без доступа к хранилищу лежит весь продуктивный контур. Небольшой инцидент превратился в аварию.
Пример 2. Блейд-корзина
Нужно заменить одно лезвие (блейд-сервер) в корзине. Документации по конфигурации и совместимым моделям нет. Инженер «на глазок» подбирает вроде бы подходящее лезвие и вставляет его в слот.
Итог: минус два лезвия, повреждённый бэкплейн корзины и остановка всех сервисов, которые на ней работали. Ехали менять одну деталь, а получили ремонт всей корзины и простой.
Почему РТО и документацию считают «воздухом»
У профилактики есть неудобное свойство: когда она работает, результата не видно. Сервер не сгорел, авария не случилась, инженер не выезжал ночью. Заказчик видит в отчёте «проведено РТО, обновлена документация» и задаётся вопросом: а за что мы, собственно, платим?
Это парадокс предотвращения. Мы хорошо видим цену аварии, которая произошла, и почти не видим цену аварии, которая не произошла.
Но экономика здесь простая. Заказчик платит за РТО и документацию не как за бесполезный воздух, а как за страховку, которая:
- сокращает количество инцидентов — по моей практике почти вдвое;
- сокращает время восстановления, потому что инженер знает, что и где;
- снижает риск того, что мелкий инцидент перерастёт в аварию;
- продлевает срок службы оборудования и откладывает его замену.
Как посчитать пользу
Чтобы перевести разговор с заказчиком из эмоций в цифры, достаточно простого сравнения:
| Что сравниваем | Профилактика | Авария |
|---|---|---|
| Когда происходит | В плановое окно | В любой момент, часто ночью и в пиковую нагрузку |
| Затраты на работы | Плановые часы инженера | Срочный выезд, аварийные работы |
| Оборудование | Расходники: фильтры, термопаста, вентиляторы | Замена сервера, лезвия, корзины |
| Простой бизнеса | Нет или минимальный, согласованный | Часы и дни, в среднем около 2 млн рублей за критичный простой |
| Репутация | Не страдает | Жалобы клиентов, штрафы по SLA |
Если за год регламентное обслуживание предотвращает хотя бы один крупный инцидент, оно, как правило, окупается многократно.
Что должно входить в РТО и документацию
Минимальный набор, который я рекомендую закладывать в любой сервисный контракт:
- Плановая очистка оборудования от пыли и проверка охлаждения — не реже раза в полгода, в запылённых помещениях чаще.
- Проверка вентиляторов, блоков питания, дисков и RAID-массивов, анализ журналов оборудования.
- Проверка ИБП и аккумуляторов.
- Актуальные схемы коммутации: LAN, SAN, питание, с маркировкой кабелей и портов.
- Паспорта и конфигурации оборудования, перечни совместимых компонентов.
- Пошаговые инструкции для типовых работ: замена лезвия, диска, блока питания.
- Правило: после любых изменений документация обновляется сразу, а не «когда-нибудь».
Вывод
Быстрая аварийная бригада — это важно. Но это последняя линия обороны, а не первая. Качественный сервис строится на регулярном обслуживании и актуальной документации: они убирают значительную часть инцидентов ещё до того, как те случились, а оставшиеся делают короче и дешевле.
Пылесос и обновлённая схема коммутации стоят несравнимо меньше, чем сгоревший сервер и остановленный бизнес. Если вы хотите выстроить сервис именно так, специалисты ИТ-сервиса Атримут помогут составить регламент обслуживания и привести документацию в порядок.
Вопросы и ответы
Что такое РТО в ИТ-инфраструктуре?
РТО — регламентное техническое обслуживание: плановые работы по графику, которые предотвращают отказы. Сюда входит очистка оборудования от пыли, проверка охлаждения, питания, дисков, журналов и обновление документации.
Как часто нужно чистить сервер от пыли?
В обычной серверной — не реже раза в полгода. В запылённых или производственных помещениях — раз в 1–3 месяца. Точную периодичность лучше определять по условиям эксплуатации и данным мониторинга температур.
Какая часть ИТ-инцидентов связана с отсутствием обслуживания?
По практике автора, около 40 % инцидентов связано с непроведённым или несвоевременным РТО и ещё около 10 % — с неактуальной документацией. По данным Uptime Institute, большинство сбоев по вине персонала связано с несоблюдением или некорректностью процедур.
Зачем платить за документацию, если инженеры и так всё знают?
Инженеры меняются, а инфраструктура со временем усложняется. Без актуальных схем и инструкций даже опытный специалист работает наугад, и небольшой инцидент может перерасти в аварию всего контура.
Андрей Громов
Технический директор ООО «Атримут»
16 лет в ИТ. Специализация — аддитивные технологии, сервисная инфраструктура, управление федеральными проектами, госсектор.