Что такое DRP: план аварийного восстановления ИТ-инфраструктуры
DRP (Disaster Recovery Plan) — план аварийного восстановления ИТ-инфраструктуры: документ, который описывает, что делать, когда что-то пошло не так. Работает он только при двух условиях: в нём есть конкретные шаги для каждого сценария, и он описывает инфраструктуру такой, какая она есть сегодня.

Начнём с академического определения. Disaster Recovery Plan (DRP) — это план аварийного восстановления ИТ-инфраструктуры. В российском стандарте ГОСТ Р ИСО/МЭК 27031-2012 он определён как «чётко определённый и документально оформленный план по восстановлению возможностей ИКТ в случае возникновения нарушения» (ГОСТ Р ИСО/МЭК 27031-2012).
Если перевести с языка стандартов на язык практики, DRP — это документ, который должен описывать шаги и сценарии действий при возникновении нештатных и аварийных ситуаций. И описывать их для текущей, актуальной инфраструктуры.
Два ключевых слова: «должен» и «актуальный»
В этом определении два слова важнее остальных.
Первое — должен. DRP не рассказывает об инфраструктуре в общих чертах и не перечисляет благие намерения. Он должен давать конкретные шаги: что делать, в каком порядке, кто это делает и как понять, что шаг выполнен. Если в аварийной ситуации инженеру приходится додумывать, план не выполнил свою задачу.
Второе — актуальный. План описывает не ту инфраструктуру, которая была на момент его написания, а ту, что работает сейчас. Любой сервер, перенесённый в другую стойку, любое изменение в настройках сети, любой сменённый пароль — всё это делает план чуть менее правдивым. А неправдивый план в аварии опаснее, чем его отсутствие: люди доверяют ему и теряют время.
DRP как карта контрольных проверок пилота
Я не имею отношения к авиации, но считаю, что DRP сродни картам контрольных проверок, по которым работают пилоты. В российских авиационных правилах прямо сказано, что карты контрольных проверок применяются экипажами «до, во время и после всех этапов полета, а также в аварийных ситуациях», а при их разработке учитывается человеческий фактор (КонсультантПлюс).
В этой аналогии важна одна деталь. Пилот отвечает на пункт карты только после того, как проверил фактическое состояние системы, а не по памяти (Studfile). Опытный экипаж с тысячами часов налёта всё равно читает карту вслух. Не потому, что пилоты не помнят порядок действий, а потому, что в стрессе память подводит даже профессионалов.
Хороший DRP работает так же: он снимает с человека необходимость вспоминать в момент, когда вспоминать некогда.
Почему к DRP относятся формально
Вроде бы с этим документом всё понятно. Документ нужный, документ важный, документ описывает все возможные шаги на случай «если что-то случилось и пошло не так».
Но практика показывает обратное. К этому действительно важному документу подходят формально, халатно или вообще о нём забывают со словами «мы и так знаем, что делать в случае чего».
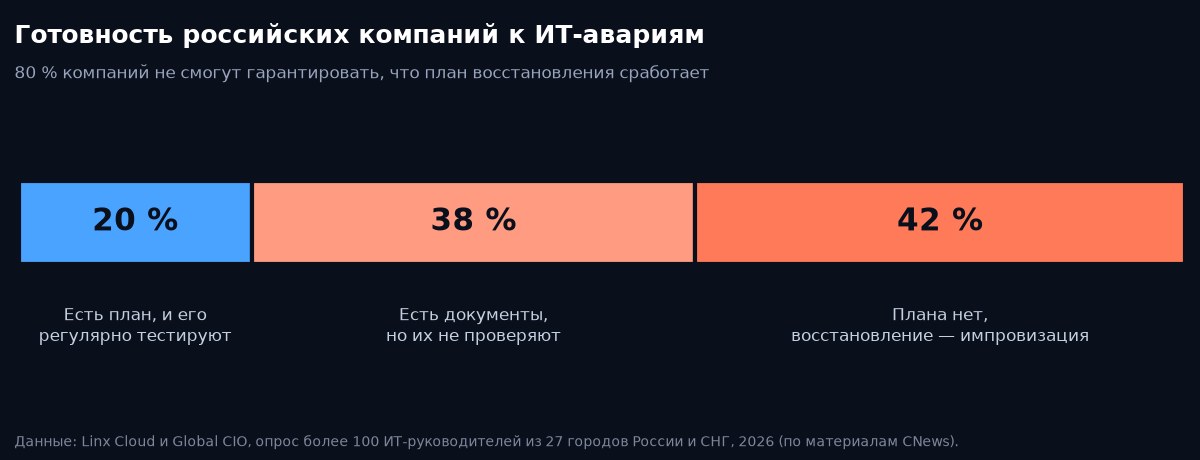
Исследования это подтверждают. По данным опроса Linx Cloud и Global CIO среди более чем 100 ИТ-руководителей России и СНГ, только у 20 % компаний есть формализованный и регулярно тестируемый план аварийного восстановления. Ещё 38 % имеют базовые документы, но не проверяют их на практике, а у 42 % плана нет вовсе (CNews).
Крупный бизнес выглядит лучше, но ненамного. По исследованию Orion soft, 86,9 % крупных компаний имеют хотя бы частично разработанные планы восстановления, но регулярно проводят учения только 34,4 %. Ещё около 37,6 % вовсе не тестируют аварийное восстановление или проверяли его один раз — при внедрении (ServerNews). А в «Инфосистемах Джет» по своему проектному опыту оценивают, что полноценный план аварийного восстановления есть лишь примерно в одной компании из двадцати (Jet Info).
Что происходит при аварии без плана
Когда авария случается, а актуального плана нет, начинается суета. Проблемы нарастают как снежный ком: каждое следующее открытие отнимает время и добавляет нервов.
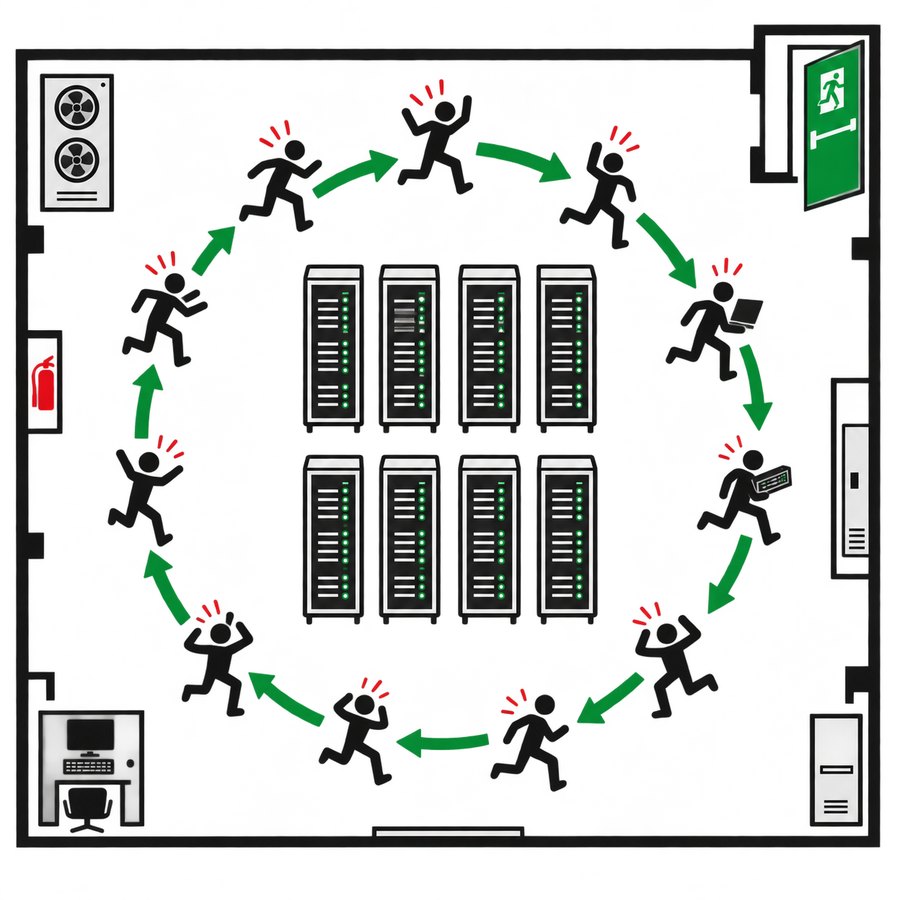
Вот как это выглядит на практике.
Контроллера домена давно нет в указанной стойке и юните. Его перенесли при модернизации, а в плане осталось старое место. Инженер приходит в серверную и ищет сервер, которого там нет.
22-й порт SSH давно закрыт на предпродуктивном контуре. Доступ перевели на другой способ, но в плане об этом ни слова. Инженер пытается подключиться привычным путём, получает отказ и тратит время на выяснение, сеть это, сервер или сама авария.
Пароль root от VipNet уже не актуален, и никто не знает, у кого актуальный. Кто-то менял его по требованиям безопасности, но не обновил данные там, где их будут искать в аварии. В итоге криптошлюз, через который идёт защищённый канал, становится недоступен для тех, кто должен его восстанавливать.
Каждый такой эпизод по отдельности — мелочь. Но в аварии они складываются: минуты превращаются в часы, а локальный сбой — в остановку бизнеса.
Что должно быть в DRP
Хороший план — не толстый, а точный. Минимальный набор разделов:
- Область действия: какие системы и сервисы покрывает план и какие из них критичны для бизнеса.
- Целевые показатели для каждой критичной системы. RTO (Recovery Time Objective, заданное время восстановления) — за какое время сервис должен заработать. RPO (Recovery Point Objective, заданная точка восстановления) — потерю данных за какой период бизнес готов допустить (ГОСТ Р ИСО/МЭК 27031-2012). Не путайте с РТО — регламентным техническим обслуживанием, о котором я писал в статье «Регламентное обслуживание серверов: почему РТО дешевле аварии».
- Роли и контакты: кто объявляет аварию, кто принимает решение о переключении, кто что делает, как связаться с каждым, включая подрядчиков и поставщиков.
- Карта инфраструктуры: где физически находится оборудование (площадка, стойка, юнит), как оно подключено, какие есть пути доступа.
- Зависимости и порядок восстановления. Ключевыми составляющими плана считаются описание зависимостей систем и последовательность их восстановления (КиберЛенинка): нет смысла поднимать приложение, пока не работают DNS, контроллер домена и база данных.
- Сценарии: пошаговые действия для типовых аварий — отказ сервера, СХД, площадки, канала связи, кибератака.
- Доступы. Сами пароли в DRP хранить нельзя. В плане фиксируется, где они хранятся (защищённое хранилище паролей), кто имеет к ним доступ и как получить доступ в аварийной ситуации.
- Критерии возврата к штатной работе: как понять, что авария закончилась, и что проверить после восстановления.
Как держать DRP актуальным
Мораль приведённых примеров проста: к плану аварийного восстановления ИТ-инфраструктуры нужно подходить ответственно и основательно, а актуализировать его регулярно, даже если аварий не было.
На практике это значит:
- обновлять план сразу после каждого изменения инфраструктуры: переноса оборудования, смены портов, правил доступа, паролей;
- пересматривать план целиком по графику, например раз в квартал или полгода, даже если изменений вроде бы не было;
- проводить учения. Проверка «за столом» лучше, чем ничего, но настоящую уверенность даёт только реальное восстановление на тестовом стенде с замером времени;
- после каждой аварии и каждого учения разбирать, где план не сработал, и сразу вносить правки.
Есть и ещё одна польза, о которой часто забывают. Актуальный DRP полезен не только в аварии, но и при плановых работах. Перед модернизацией, переездом или обновлением инженер сразу видит зависимости, порядок отключения и включения систем и точки, где что-то может пойти не так. План аварийного восстановления становится рабочим справочником инфраструктуры.
Вывод
DRP — это не формальность для аудитора и не папка на полке. Это карта контрольных проверок для ИТ-инфраструктуры, которая работает только при двух условиях: в ней есть конкретные шаги и она описывает то, что есть на самом деле.
Время, потраченное на подготовку и актуализацию плана, окупается в первой же аварии: вместо суеты и бега по кругу команда работает по шагам. Если нужно разработать DRP с нуля или провести ревизию существующего, специалисты ИТ-сервиса Атримут помогут описать инфраструктуру, сценарии и провести учения.
Вопросы и ответы
Что такое DRP простыми словами?
DRP (Disaster Recovery Plan) — план аварийного восстановления ИТ-инфраструктуры. Это документ с пошаговыми действиями на случай аварии: что восстанавливать, в каком порядке, кто отвечает и за какое время сервисы должны заработать.
Чем DRP отличается от BCP?
BCP (Business Continuity Plan, план обеспечения непрерывности бизнеса) описывает, как продолжать работу всей организации при нарушениях. DRP — его ИТ-часть: он отвечает за восстановление информационных систем и инфраструктуры, без которых бизнес-процессы не работают.
Как часто нужно обновлять и тестировать DRP?
Обновлять — после каждого изменения инфраструктуры и по графику, например раз в квартал или полгода. Тестировать критичные сценарии рекомендуется хотя бы раз в год, а для наиболее важных систем — чаще.
Что такое RTO и RPO в плане аварийного восстановления?
RTO (Recovery Time Objective) — время, за которое сервис должен быть восстановлен после сбоя. RPO (Recovery Point Objective) — момент, к которому должны быть восстановлены данные, то есть допустимый объём их потери.
Андрей Громов
Технический директор ООО «Атримут»
16 лет в ИТ. Специализация — аддитивные технологии, сервисная инфраструктура, управление федеральными проектами, госсектор.